Wie funktioniert die OpenRouter-Abrechnung? Schichten erklärt
Wie funktioniert die OpenRouter-Abrechnung? Kurz gesagt: Jedes Modell hat einen eigenen Preis pro Million Input-Token und pro Million Output-Token, festgelegt vom jeweiligen Anbieter. Du zahlst aus Prepaid-Guthaben auf dem Router-Konto. Dieser Artikel listet die zu prüfenden Schichten auf und vergleicht sie mit einem Festpreis.
Aktualisiert
Wichtige Punkte
- Router-Rechnungen kombinieren einen pro-Modell-Tokenpreis, Anbieterunterschiede und eventuelle Gebühren auf Router-Seite; lies die aktuelle Preisliste für genaue Zahlen.
- Input- und Output-Token werden überall separat abgerechnet, und Output kostet normalerweise mehr.
- Ein Festpreis-Modell hat einen Input- und einen Output-Satz: $0,15 bzw. $0,50 pro 1M Token hier.
- Schätze die Kosten mit einem kurzen Skript, das das usage-Feld jeder Antwort ausliest.
Die Preisschichten eines Routers
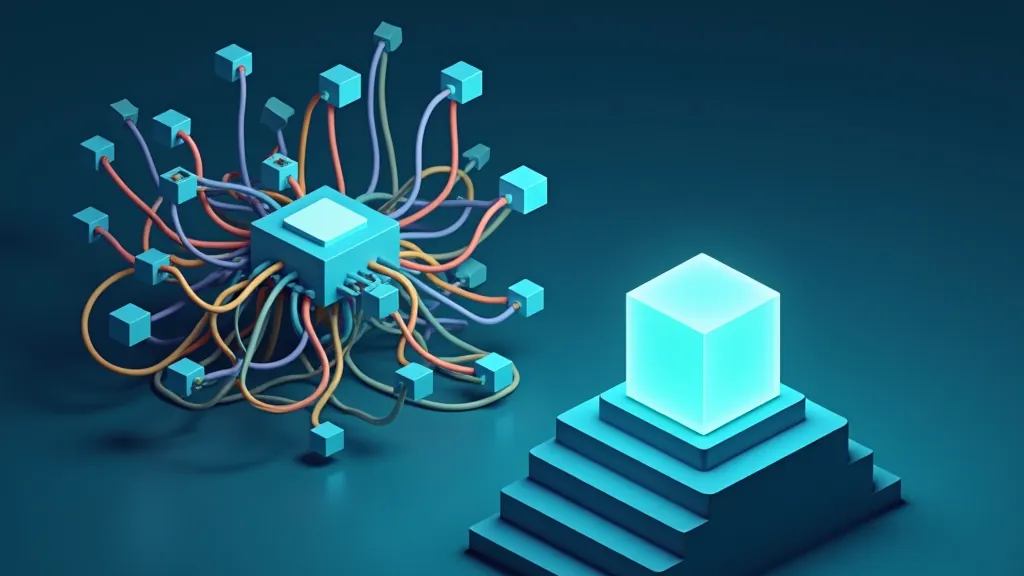
Ein Router verkauft Zugang zu Modellen vieler Anbieter. Das erzeugt eine Schichtstruktur der Kosten. Ich beschreibe die Struktur hier und überlasse genaue Zahlen den Router-Seiten, da sie sich ändern und ich sonst raten müsste.
- Modell-Tokenpreis. Jedes Modell listet einen Satz pro 1M Input (Prompt) Token und pro 1M Output (Completion) Token. Größere Modelle kosten mehr als kleinere, oft deutlich mehr.
- Anbieterauswahl. Dasselbe Modell wird von verschiedenen Anbietern mit unterschiedlichen Preisen, Geschwindigkeiten und Limits gehostet. Ein Router kann einen Anbieter basierend auf Preis, Geschwindigkeit oder Verfügbarkeit auswählen, sodass sich deine effektive Rate ändern kann.
- Router-seitige Gebühren. Prüfe, ob der Router eine Gebühr beim Kauf von Guthaben erhebt, einen Aufschlag auf die Nutzung oder Mindestkaufbeträge.
- Spezielle Modellvarianten. Einige Kataloge listen kostenlose oder rabattierte Varianten mit strengeren Limits auf. Lies die Limits, bevor du darauf aufbaust.
- Zusatzfunktionen. Alles über reinen Text hinaus, wie Bild-Input oder Tool-Nutzung, kann vom Modell anders abgerechnet werden.
Das ist alles nicht schlecht. Es ist der Preis dafür, dass hinter einem Schlüssel hundert Modelle stehen. Das Problem ist nur, dass eine Abrechnung schwerer vorhersehbar ist. Für einen breiteren Vergleich sieh dir OpenRouter API Alternativen im Vergleich an.
Token, Input versus Output
Unabhängig vom Anbieter werden Token abgerechnet. Ein Token ist ein Textstück, etwa vier englische Zeichen. Ein Prompt von 1.000 Wörtern sind etwa 1.300 Token. Input-Token decken alles ab, was du sendest: System-Prompt, Chat-Verlauf, Dokumente, Tool-Definitionen. Output-Token sind das, was das Modell zurückschreibt.
Output kostet pro Token normalerweise mehr als Input, daher kostet eine gesprächige Antwort mehr als ein langer Prompt gleicher Größe. Chat-Apps senden den Verlauf bei jedem Schritt erneut, was die Input-Kosten über einen Chat-Verlauf wachsen lässt, auch wenn jede Antwort kurz ist.
Der genaue Tokenizer unterscheidet sich je nach Modell, daher kann derselbe Text auf verschiedenen Modellen als unterschiedliche Menge zählen. Beim Vergleich zweier Modelle nach Preis, vergleiche die Kosten für deinen eigenen Prompt-Satz, nicht die Preislisten.
Rechenbeispiel: derselbe Monat, zwei Modelle
Angenommen, eine Arbeitslast von 30M Input-Token und 6M Output-Token pro Monat. Modell A auf einem Router hat, für dieses fiktive Beispiel, einen Preis von $1 und $4 pro Million Input- und Output-Token. Diese Zahlen sind nur für das Beispiel erfunden. Die Rechnung beträgt 30 x $1 + 6 x $4 = $30 + $24 = $54, plus eventuelle Gebühren.
Auf einem Festpreis-Endpunkt zu $0,15 pro 1M Input und $0,50 pro 1M Output kostet das gleiche Volumen 30 x $0,15 + 6 x $0,50 = $4,50 + $3,00 = $7,50. Das ist kein Argument dafür, dass günstiger immer besser ist. Die beiden Modelle verhalten sich unterschiedlich, und das größere Modell ist vielleicht das, was deine Aufgabe braucht. Es zeigt, warum du dein tatsächliches Volumen beziffern solltest, statt nur auf die Kopfpreise zu schauen.
Ein weiterer praktischer Punkt: Viele Router zeigen einen Preis für eine typische Anfrage neben dem Modell. Multipliziere ihn mit deinen täglichen Anfragen und mit 30, um einen Plan vor der Verpflichtung zu prüfen.
Die Festpreis-Alternative
Der Endpunkt dieser Seite, https://api.openrouteralternativeapi.com/v1, hat ein Modell, uncensored, und eine Preisliste. Input ist $0,15 pro 1M Token und Output ist $0,50 pro 1M. Du zahlst aus Prepaid-Guthaben ohne Abonnement, fehlgeschlagene oder abgelehnte Anfragen werden nicht berechnet, und Guthaben verfällt nie. Es gibt keine Router-Schicht: Das Modell wird von einem unabhängigen Anbieter betrieben und ist kein offizielles Produkt eines großen Labors.
Das macht die Kostenprognose zu einer Ein-Zeilen-Berechnung. Ein Aufruf mit 2.000 Input-Token und 500 Output-Token kostet 2.000 x $0,15 / 1M + 500 x $0,50 / 1M = $0,0003 + $0,00025 = $0,00055. Tausend solcher Aufrufe kosten $0,55. Wenn du viele verschiedene Modelle brauchst, ist ein Router die bessere Wahl; wenn du eines brauchst, ist Festpreisabrechnung einfacher zu durchdenken. Sieh dir die Preisliste für Auflade-Boni an.
Ermittle die echten Kosten mit einem kleinen Skript
Vertraue Schätzungen nicht zu lange. Die Antwort enthält einen usage-Block mit Prompt- und Completion-Token-Anzahlen, und diese API gibt auch einen X-Balance-USD-Header mit deinem verbleibenden Guthaben zurück. Nutze eines von beiden, um die Kosten pro Aufruf zu protokollieren:
from openai import OpenAI
client = OpenAI(base_url="https://api.openrouteralternativeapi.com/v1", api_key="YOUR_KEY")
PRICE_IN, PRICE_OUT = 0.15, 0.50 # dollars per 1M tokens
def run(prompt):
r = client.chat.completions.create(
model="uncensored",
messages=[{"role": "user", "content": prompt}],
)
u = r.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1e6
return r.choices[0].message.content, cost
text, cost = run("List three risks of changing a database schema live.")
print(f"cost this call: ${cost:.6f}")Führe es mit hundert echten Prompts aus, und du erhältst die Kosten pro Aufgabe, die deine tatsächlichen Prompt-Längen berücksichtigen. Führe denselben Test auf einem Router mit einem Modell deiner Wahl durch, verwende die Werte aus deren Dashboard und vergleiche die beiden Gesamtkosten. Der Artikel über den OpenRouter-ähnlichen OpenAI-kompatiblen Endpunkt erklärt, wie die Client-Seite identisch ist.
Budgetierung und Aufladung
Lege ein Budget fest, bevor du startest. Prepaid-Guthaben hilft hier, da du nicht mehr ausgeben kannst, als du aufgeladen hast. Bei dieser API sind Aufladungen jeder ganze Betrag von $20 bis $500, mit +5% ab $50, +10% ab $100 und +15% ab $200. Eine Aufladung von $100 gibt $110 Guthaben. Bei den $0,00055 pro Aufruf oben sind das 200.000 Aufrufe.
Du kannst mit Krypto (USDT auf TRC20, USDC auf Base) bezahlen. Ratenlimits schützen dein Budget: Ein voller Schlüssel ist auf 8 parallele Anfragen und 300 pro Minute begrenzt, ein Test-Schlüssel auf 2 und 60, mit HTTP 429 darüber hinaus. Es kostet nichts, es zu versuchen: Sichere dir das $0,50 Testguthaben auf der API-Schlüssel-Seite, keine Karte, gültig 7 Tage. Endpunktdetails stehen in den Docs.
Weitere Anleitungen
Fragen und Antworten
Berechnet OpenRouter pro Token?
Ja, jedes Modell listet einen Preis pro Million Input-Token und pro Million Output-Token. Prüfe die aktuelle Preisliste für genaue Raten und eventuelle Gebühren.
Warum kostet dasselbe Modell auf einem Router unterschiedlich viel?
Verschiedene Anbieter hosten dasselbe Modell zu unterschiedlichen Preisen, und der Router kann zwischen ihnen wählen. Prüfe, wie deine Anfragen geroutet werden.
Wie wird diese API abgerechnet?
Ein fester Preis von $0,15 pro 1M Input-Token und $0,50 pro 1M Output-Token, bezahlt aus Prepaid-Guthaben ohne Abonnement.
Werde ich für fehlgeschlagene Anfragen hier berechnet?
Nein. Fehlgeschlagene oder abgelehnte Anfragen werden nicht berechnet.
